При поверхностном взгляде кажется, что искусственный интеллект впитывает знания подобно ребенку. На деле метафора хромает. Нейронная сеть не познает мир, а подбирает математическую функцию столь высокой размерности, что человеческий мозг не способен ее визуализировать. обучение нейросетей
В 2026 году мы ушли от романтизации процесса. Рассмотрим сухой остаток: настройку миллионов параметров так, чтобы минимизировать численную ошибку. Никакой магии, только вычислительная математика и продуманная инженерия данных.
Что скрывается за настройкой нейросетей
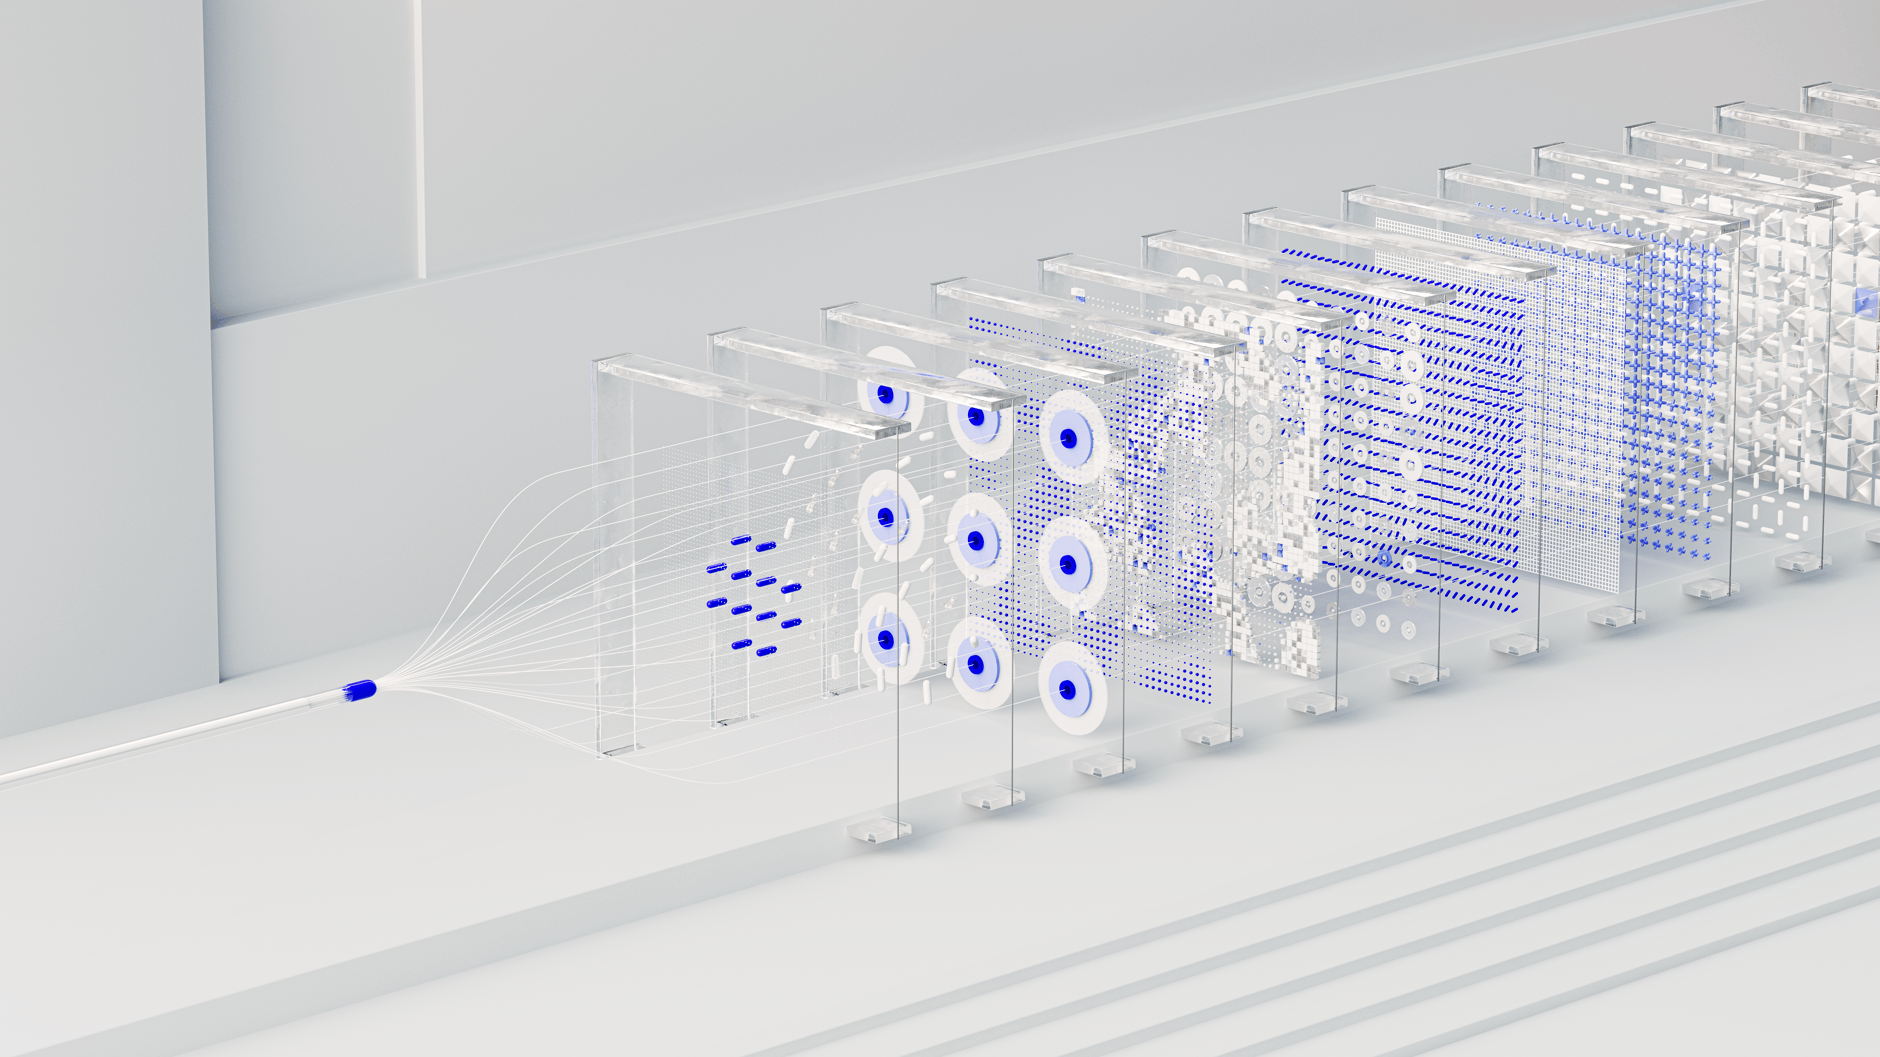
Лабиринт весов и активаций: метафора настройки инструмента
Вес — это коэффициент, определяющий силу связи между искусственными нейронами. Современная LLM с архитектурой трансформер содержит сотни миллиардов таких связей.
До начала тренировки это лабиринт без карты: входной сигнал умножается на случайные величины, проходит через нелинейные функции активации (ReLU, GELU, Swish) и выдает белый шум на выходе.
Настройка заключается в систематическом изменении этих коэффициентов. Это не «мышление», а поиск оптимального состояния многомерного тензора. Удачная конфигурация весов позволяет модели переводить текст, распознавать снимки МРТ или писать код с минимальной ошибкой.
Функция потерь — компас, указывающий путь к идеальной модели
Алгоритм не имеет глаз. Чтобы понять, насколько ответ далек от реальности, используется функция потерь (loss function) — численная метрика расхождения. Для задачи регрессии часто берут среднеквадратичную ошибку (MSE). Для мультиклассовой классификации — категориальную кросс-энтропию.
Функция потерь дает единственное число — «цену» ошибки на всем пакете данных. Если предсказание точно совпадает с эталоном, значение падает до нуля. Если модель ошибается катастрофически, лосс резко взлетает. Это компас, указывающий направление: нужно двигаться туда, где значение метрики минимально.
Градиентный спуск и его вариации: как не увязнуть в оврагах ошибок
Наивный подход — перебрать все комбинации весов — нереализуем даже на квантовом компьютере. Поэтому используют градиентный спуск. Мы вычисляем производную функции потерь по каждому весу, чтобы понять, как изменение конкретного параметра влияет на итоговую ошибку.
Классический SGD (стохастический градиентный спуск) делает шаги фиксированного размера, но часто застревает в седловых точках или осциллирует в узких каньонах ландшафта потерь. Адаптивные методы 2025–2026 годов решают эту проблему:
- Adam. Накапливает инерцию (первый момент) и масштабирует шаги обучения (второй момент), автоматически замедляясь на крутых склонах.
- AdamW. Декоррелирует регуляризацию весов (weight decay) от адаптивного шага, что для трансформеров стало стандартом де-факто.
- RMSprop. Нормализует градиент по скользящему среднему квадратов, игнорируя знак, что полезно для рекуррентных архитектур.
Обратное распространение ошибки: настройка оркестра
Метод обратного распространения ошибки (backpropagation) — алгоритмический фундамент обучения многослойных перцептронов. Суть в цепном правиле из матанализа: градиент функции потерь по весам первого скрытого слоя зависит от градиентов всех последующих слоев.[1]
Сигнал ошибки движется от выходного слоя к входному. Каждый нейрон получает свой «вклад» в общую ошибку. Связи, активировавшиеся сильнее и приведшие к неверному ответу, получают наибольшую корректировку. Это похоже на дирижера, который поочередно указывает группам инструментов, где они сфальшивили.
Датасет — топливо для обучения: почему качество данных важнее их количества
Модель не может выучить то, чего не видела. Если в тренировочном корпусе 90% примеров одного класса, классификатор выродится в «глупого предсказателя», всегда выдающего мейджорити-класс.
Для больших языковых моделей (LLM) критично удаление дубликатов, устранение PII (персональной информации) и фильтрация токсичного контента. Исследования по обучению нейросетей показывают: очистка данных и аугментация повышают итоговую точность сильнее, чем увеличение числа параметров на порядок.
Сырой датасет из Common Crawl без обработки зашумляет предсказания даже мощной архитектуры.
Три кита машинного обучения: сравнение подходов
Выбор парадигмы зависит от разметки данных и типа обратной связи. Ниже — сравнительный анализ трех основных методов.
| Критерий | С учителем (Supervised) | Без учителя (Unsupervised) | С подкреплением (Reinforcement) |
|---|---|---|---|
| Тип входных данных | Пары (признаки, метка) | Только признаки | Состояния среды и скаляр награды |
| Обратная связь | Мгновенная, точная | Отсутствует | Отложенная, зашумленная |
| Типичные задачи | Классификация снимков, регрессия цен | Кластеризация клиентов, PCA-сжатие | Управление дронами, игровые боты |
| Алгоритмическая база | Градиентный спуск, кросс-энтропия | K-means, DBSCAN, автоэнкодеры | Q-learning, Policy Gradients (PPO) |
| Риски | Переобучение, дорогая разметка | Неинтерпретируемые кластеры | Нестабильность сходимости, reward hacking |
Обучение с учителем: размеченные данные и мгновенная связь
Самый зрелый подход. Каждому входному образцу соответствует целевое значение (ground truth). Алгоритм корректирует веса, чтобы минимизировать разницу между предсказанным и истинным ответом. Используется в 80% индустриальных систем: от детекции дефектов на конвейере до скоринга кредитных заявок.
Обучение без учителя: поиск скрытых структур
Здесь нет правильных ответов. Модель ищет паттерны в распределении признаков. Кластеризация выделяет группы схожих объектов, понижение размерности (UMAP, t-SNE) проецирует 1000-мерное пространство эмбеддингов на плоскость для визуализации.
Генеративные состязательные сети (GAN) также относятся сюда: генератор не получает меток, а учится, соревнуясь с дискриминатором.
Обучение с подкреплением: отложенное вознаграждение
Агент действует в среде (симуляторе), получая награду или штраф спустя множество шагов.
В 2026 году алгоритм PPO (Proximal Policy Optimization) остается рабочей лошадкой для fine-tuning’а LLM под пользовательские предпочтения (RLHF).[2] Отличие от supervised learning в том, что агенту не показывают «правильный» ход — он нащупывает стратегию методом проб и ошибок.
Гибридные стратегии: goldilocks-зона
Разметка гигабайтовых корпусов — дорого. Self-supervised learning маскирует часть входных данных и заставляет модель предсказывать пропущенное (Masked Language Modeling). Модель сама генерирует метки из структуры данных.
Semi-supervised методы комбинируют небольшой пул размеченных примеров с огромным массивом неразмеченных, что позволяет дообучать модели для специфичных доменов вроде анализа медицинских карт.
Пошаговый процесс тренировки: от сырых данных до умной модели
Технически тренировка — это итеративный конвейер, разбитый на восемь обязательных этапов.
- Формирование и предобработка датасета. Сырые логи, изображения, аудио конвертируются в тензоры. Проводится очистка от выбросов, удаление дубликатов, аугментация (цветовой сдвиг, повороты), нормализация (Z-score или MinMax).
- Выбор архитектуры. Для картинок — сверточные сети (ConvNeXt), для текстов — трансформеры с self-attention, для временных рядов — Mamba или xLSTM. Архитектура определяет индуктивное смещение модели.
- Инициализация параметров. Веса не могут быть нулевыми или слишком большими. Инициализация He подходит для ReLU-подобных функций, Xavier — для симметричных сигмоид. Правильный старт предотвращает «взрыв градиентов» на первых эпохах.
- Прямой проход (forward pass). Входной батч матрично перемножается с весами слоев. Результат — вектор логитов или регрессионное значение.
- Подсчёт функции потерь. Вычисляется скаляр, отражающий расстояние до истины.
- Обратное распространение. Фреймворк автоматического дифференцирования (autograd в PyTorch) вычисляет градиенты лосса по всем узлам графа вычислений.[3]
- Обновление весов. Оптимизатор (AdamW) принимает градиенты и обновляет параметры согласно learning rate и внутренней статистике моментов.
- Валидация и ранняя остановка. На отложенной выборке отслеживают метрику. Если лосс на валидации перестал падать и начал расти — тренировку прекращают, сохраняя чекпойнт с лучшим значением метрики.
Тонкая настройка и дообучение готовых моделей
В 2026 году тренировать модели с нуля экономически оправдано считанным компаниям. Массовый тренд — адаптация предобученных гигантов.
Трансферное обучение: заимствование мудрости
Берем ResNet или ViT, предобученный на ImageNet-21k. Отсекаем классификационную голову (последний слой) и прикрепляем собственную. Базовая часть сети уже умеет выделять низкоуровневые признаки (грани, текстуры). Новой задаче нужно лишь настроить специфичную комбинаторику на верхних слоях.
Это сокращает потребность в GPU-часах на порядок.
Fine-tuning: предотвращение катастрофического забывания
При дообучении на узкой задаче сеть может резко «забыть» полезные признаки. Используют низкий темп обучения (1e-5 против 1e-3 для головы) и дифференцированный размороз слоев. Для LLM применяют LoRA — низкоранговые адаптеры, которые вносят изменения в веса, не трогая основные миллиарды параметров.
Это позволяет хранить сотни тонких настроек без раздувания памяти.
Регуляризация и dropout: страховка от переобучения
Dropout случайно обнуляет часть выходов нейронов (например, 20% во время прохода). Это создает ансамбль подсетей внутри одной архитектуры и не дает нейронам «лениться», полагаясь на соседей.
Другие техники: Stochastic Depth (пропуск целых блоков), Label Smoothing (смягчение one-hot векторов) и Data Augmentation.
Они формируют более гладкий ландшафт потерь, где модель менее чувствительна к шуму в данных.[4]
Ландшафт лосс-функции: география тренировки
Поверхность функции потерь в многомерном пространстве не похожа на гладкую чашу. Она изобилует седловыми точками (где градиент близок к нулю, но минимума нет) и плато. Адаптивные оптимизаторы помогают выбраться из таких областей. Исследования связывают плоские минимумы с лучшим обобщением.
Острые минимумы дают отличные метрики на обучении, но проваливаются на тесте при малейшем сдвиге распределения данных.
Генеративные нейросети: создание миров
Диффузионные модели (DDPM) учатся инвертировать процесс зашумления. Начиная со случайного шума, они шаг за шагом денойзят его в связное изображение. VAE сжимают объект в вероятностное латентное пространство и декодируют обратно.
В этих архитектурах цель обучения — не присвоить метку, а смоделировать распределение p(x), чтобы генерировать неотличимые от реальных синтетические образцы.
Примечания и ссылки
- [1] https://www.nature.com/articles/323533a0 — Rumelhart, D. , Hinton, G. , Williams, R. Learning representations by back-propagating errors. Nature 323, 533–536 (1986). Классическая работа, заложившая основу современным методам настройки многослойных сетей.
- [2] https://arxiv.org/abs/1707.06347 — Schulman, J. et al. Proximal Policy Optimization Algorithms (2017). Алгоритм PPO, применяемый в RLHF для выравнивания поведения ИИ-ассистентов.
- [3] https://pytorch.org/tutorials/ — PyTorch Documentation. Официальные руководства по реализации autograd и тренировочных циклов.
- [4] https://www.deeplearningbook.org/ — Goodfellow, I. , Bengio, Y. , Courville, A. Deep Learning (MIT Press, 2016). Глава 7: Регуляризация в глубоких нейросетях.
Заключение
Процесс настройки нейросетей к 2026 году эволюционировал от кустарных экспериментов к промышленному конвейеру. Ключевые тектонические сдвиги — доминирование self-supervised предобучения, повсеместное использование LoRA и смещение фокуса с размера архитектуры на качество обработанного датасета.
Инженер, понимающий физику градиентного спуска и механизмы регуляризации, перестает быть оператором «черного ящика» и превращается в конструктора предсказуемых аналитических систем.
Часто задаваемые вопросы (faq)
Сколько времени занимает обучение современной нейросети?
Зависит от масштаба. ResNet-50 на ImageNet (~1.2 млн изображений) тренируется на 8 GPU A100 около 18 часов. LLM уровня LLaMA-3 (70B параметров) на кластере из тысяч ускорителей требует порядка 2–3 месяцев непрерывных вычислений и миллионы долларов бюджета.
Тонкая настройка адаптерами (LoRA) на одной карте может занять 20 минут.
Что такое переобучение и как его заметить на графиках лосса?
Состояние, когда модель запомнила шум и артефакты тренировочной выборки, а не общие закономерности. На графиках видно расхождение кривых: тренировочный лосс монотонно падает, а валидационный после определенной эпохи начинает расти или плато, отрываясь вверх.
Также наблюдается рост gap между accuracy на обучении и на валидации (дельта > 5–10%).
Для простых задач классификации изображений подойдут AutoML-платформы (Google Vertex AI, Teachable Machine). Они предоставляют drag-and-drop интерфейс. Однако построить кастомный пайплайн с чисткой данных, нестандартной функцией потерь и распределенной тренировкой без Python и SQL невозможно.
Как выбрать оптимальный темп обучения (learning rate)?
Используют LR Range Test. Модель тренируется в течение нескольких итераций с экспоненциально растущим темпом обучения. Отслеживают значение лосса.
Оптимальная точка лежит на участке самого крутого спуска функции потерь, обычно прямо перед моментом, где лосс начинает падать с максимальной скоростью, но еще не осциллирует.
Анастасия Колкова
Опыт: 5 лет в разработке и оптимизации нейронных сетей, машинного обучения и глубокого обучения.
Ключевые навыки:
1. Разработка и тренировка моделей (CNN, RNN, Transformers, GAN).
2. Опыт работы с фреймворками: TensorFlow, PyTorch, Keras.
3. Обработка данных, NLP и компьютерное зрение.
4. Оптимизация производительности и масштабируемость моделей.
Достижения:
1. Успешные проекты в области чат-ботов, рекомендательных систем и анализа изображений.
2. Участие в хакатонах и конференциях по ИИ.
Образование: Высшее техническое (прикладная математика, IT).
Цель: Создавать инновационные решения на основе нейросетей для автоматизации и улучшения бизнес-процессов.